Los subtítulos cerrados son una forma eficaz de mejorar la accesibilidad, la participación y la retención de información durante presentaciones y eventos en vivo.
Los subtítulos automáticos convierten el habla en texto que se muestra en pantalla en tiempo real en el mismo idioma que el habla. ASR - Reconocimiento Automático del Habla - es una forma de inteligencia artificial utilizada para producir estas transcripciones de oraciones habladas.
Tasa de error de palabras
Para evaluar la precisión de los subtítulos automáticos, la métrica más utilizada es la Tasa de Error de Palabras (WER). Esta mide la cantidad de errores en la transcripción automática en comparación con las palabras reales pronunciadas por el hablante. En esencia, proporciona una forma de determinar qué tan bien el sistema automático está convirtiendo el habla en texto.
Por ejemplo, si 4 de cada 100 palabras están incorrectas, la precisión sería del 96%.
La tasa de error de palabras (WER) es una métrica utilizada para medir la precisión de los subtítulos automáticos. Alinea secuencias de palabras identificadas correctamente a nivel granular antes de calcular el número total de correcciones necesarias para alinear completamente los textos de referencia y de la transcripción. Esto incluye la identificación de sustituciones, eliminaciones e inserciones. El WER se calcula dividiendo el número de ajustes necesarios entre el número total de palabras del texto de referencia. En términos generales, cuanto menor sea el WER, más preciso será el sistema de reconocimiento de voz.
WER pasa por alto la naturaleza de los errores
La medida WER puede ser engañosa porque no nos indica cuán relevante/importante es un determinado error. Los errores simples, como la ortografía alternativa de la misma palabra (movable/moveable), no suelen ser considerados errores por el lector, mientras que una sustitución (exemptions/essentials) podría tener un mayor impacto.
Los números de WER, particularmente para sistemas de reconocimiento de voz de alta precisión, pueden ser engañosos y no siempre corresponden a las percepciones humanas de corrección. Para los humanos, las diferencias en los niveles de precisión entre el 90% y el 99% a menudo son difíciles de distinguir.
| Transcripción original: | Salida de subtítulos ASR: |
| Por ejemplo, yo realmente me gusta que solo se haga un uso muy limitado de la esenciales siempre y cuando me gustaría profundizar en un punto particular, temo que hago un llamado a los parlamentos estatales individuales para ratificar la convención solo después de que se haya aclarado el papel del tribunal europeo de justicia, lo que podría tener efectos muy perjudiciales. | Por ejemplo, yo también quisiera que se haga un uso muy limitado de las exenciones proporcionadas. Me gustaría profundizar en un punto particular con más detalle. Temo que el llamado a los parlamentos estatales individuales para ratificar la convención solo después de que se haya aclarado el papel del tribunal europeo de justicia podría tener efectos muy perjudiciales. |
Tasa de error de palabras percibida de Interprefy's
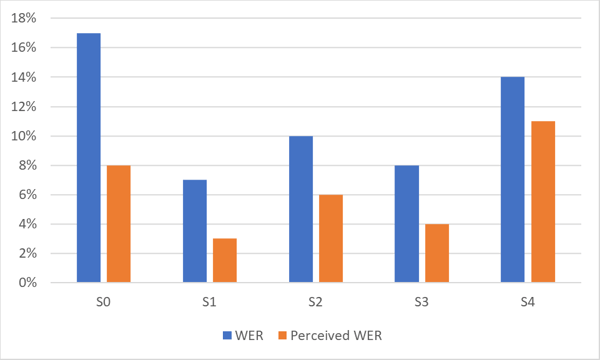
Interprefy ha desarrollado una métrica propietaria y específica por idioma de ASR llamada WER percibido. Esta métrica solo cuenta los errores que afectan la comprensión humana del discurso y no todos los errores. Los errores percibidos suelen ser más bajos que el WER, a veces incluso hasta un 50 %. Un WER percibido del 5‑8 % suele ser apenas perceptible para el usuario.
El gráfico a continuación muestra la diferencia entre la Tasa de error de palabras (WER) y la Tasa de error percibida (WER percibido) para un sistema ASR altamente preciso. Observe la diferencia en el rendimiento para diferentes conjuntos de datos (S0-S4) del mismo idioma.
Como se muestra en el gráfico, el WER percibido por los humanos suele ser sustancialmente mejor que el WER estadístico.
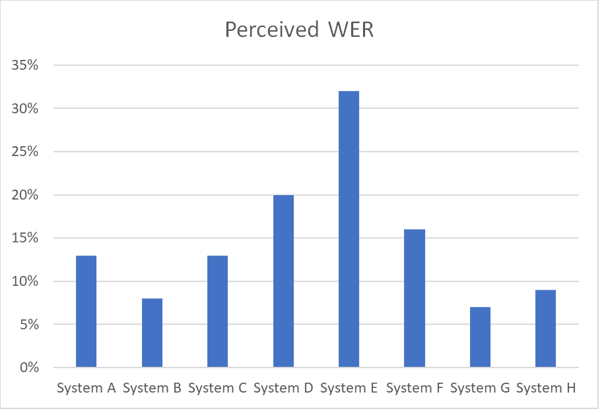
El gráfico a continuación ilustra las diferencias de precisión entre varios sistemas ASR que trabajan con el mismo conjunto de datos de voz en un determinado idioma utilizando el WER percibido.
Factores clave para lograr subtítulos cerrados increíblemente precisos
Hay tres aspectos clave que debe considerar:
- Utilice una solución de primera categoría: En lugar de elegir cualquier motor listo para usar que cubra todos los idiomas, opte por un proveedor que utilice el mejor motor disponible para cada idioma en su evento.
- Optimice el motor: elija un proveedor que pueda complementar la IA con un diccionario a medida para garantizar que los nombres de marcas, nombres poco comunes y acrónimos se capturen adecuadamente.
- Asegúrese de una entrada de audio de alta calidad: si la entrada de audio es deficiente, el sistema ASR no podrá lograr una calidad de salida. Asegúrese de que el habla se capture con claridad y a un volumen alto.